
Il caso Google-Spirit Airlines e cosa insegna a chi si occupa di privacy e AI Act
Il 2 maggio 2026 Spirit Airlines, storica compagnia low-cost americana, ha cessato le operazioni dopo un secondo fallimento in due anni, travolta da oltre 8 miliardi di dollari di debiti. Come accade in ogni procedura fallimentare, il curatore ha iniziato a liquidare gli asset: aerei, contratti di leasing, marchi. Ma tra i lotti messi all’asta ce n’è stato uno che non ha precedenti nella storia del diritto fallimentare aeronautico: la memoria digitale dell’azienda.
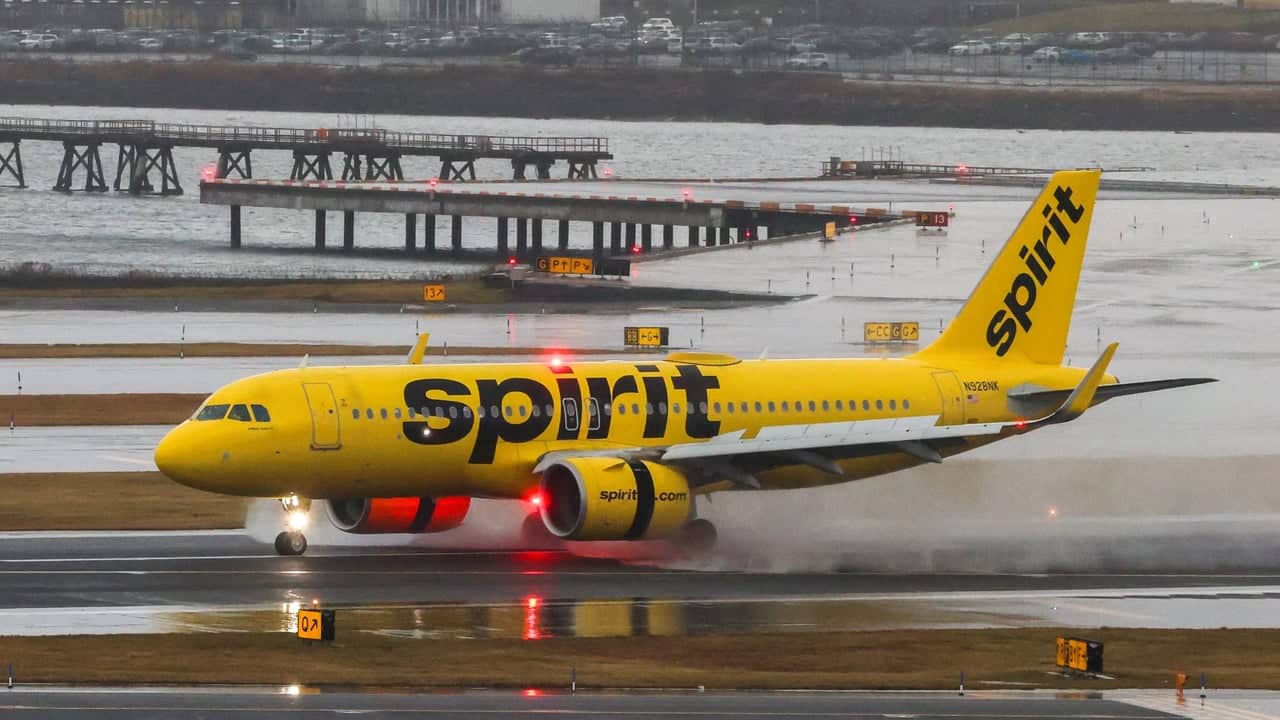
Google si è aggiudicata l’asta con un’offerta di 10 milioni di dollari, superando la concorrente Mercor (specializzata in dati per l’addestramento di IA, ferma a 7,5 milioni). Nel lotto: circa 100 milioni di email aziendali, 500 milioni di messaggi Microsoft Teams, circa 30 milioni di righe di codice sorgente, oltre a calendari, fogli di calcolo, materiali di marketing, documenti HR, audit interni e persino oltre 175.000 fascicoli del personale risalenti fino al 1986. Restano invece esclusi i dati dei passeggeri e del programma fedeltà Free Spirit, oggetto di tutele specifiche e non ceduti nell’operazione.
Una cifra minuscola per gli standard di Alphabet, ma un segnale enorme per chiunque si occupi, professionalmente, di protezione dei dati, governance informativa e intelligenza artificiale.
Perché proprio le email di un’azienda fallita
La domanda che chiunque si è posto leggendo la notizia è: perché Google dovrebbe voler comprare le email interne di una compagnia aerea in bancarotta?
La risposta sta in un limite tecnico che oggi frena lo sviluppo degli agenti IA. Sul codice sorgente, i modelli linguistici hanno fatto passi da gigante, perché il codice è un dominio “verificabile”: una funzione compila oppure no, un test passa oppure no. Questo si presta perfettamente all’apprendimento per rinforzo (reinforcement learning), la tecnica con cui un modello viene addestrato tramite un segnale di ricompensa legato al risultato ottenuto.
Il lavoro d’ufficio, invece, non funziona così. Rispondere a un cliente irritato, gestire un conflitto tra reparti, negoziare una scadenza, scrivere una mail che comunica una decisione delicata senza scatenare una crisi: sono attività fatte di contesto, relazioni, tono, ambiguità. Non esiste un “test” che dica se una mail aziendale ha funzionato o no, nel modo in cui esiste per una riga di codice. È il problema, ben noto nella ricerca sull’IA, della scarsità di dati “verificabili” per compiti non strutturati: mancano dataset su scala di internet che mostrino davvero come le persone lavorano, comunicano, sbagliano e correggono il tiro in un contesto aziendale reale.
Gli archivi di un’azienda che ha operato per decenni — con tutte le sue inefficienze, i suoi errori, le sue dinamiche interne — sono esattamente il tipo di materiale che manca. Ed è per questo che una compagnia aerea fallita, paradossalmente, vale più come dataset che come flotta.
Il nodo privacy: cosa significa davvero “deidentificato”
Nella documentazione depositata presso il tribunale fallimentare di New York, i legali di Spirit hanno dichiarato che i dati ceduti non conterranno informazioni personali identificabili e che saranno “deidentificati” prima del trasferimento, con l’impegno contrattuale di Google a non tentare la re-identificazione.
Il sindacato dei lavoratori del settore aereo (AFA-CWA) ha però sollevato un’obiezione tecnicamente fondata: la deidentificazione formale non elimina necessariamente quella che viene definita “integrità referenziale” del dataset. In altre parole, anche togliendo nomi e indirizzi email, le dinamiche di comunicazione — chi scrive a chi, con quale frequenza, in quali orari, con quale stile — possono restare sufficientemente distintive da rendere identificabile una persona con un ragionamento induttivo, specie incrociando i dati con informazioni pubbliche (LinkedIn, organigrammi, comunicati stampa).
È un tema che chi lavora nella data protection europea conosce bene, perché è esattamente la differenza tra anonimizzazione e pseudonimizzazione su cui insiste il Considerando 26 del GDPR: un dato è realmente anonimo solo quando la re-identificazione è ragionevolmente impossibile, tenuto conto di tutti i mezzi che il titolare o un terzo potrebbero ragionevolmente utilizzare. Se quei mezzi esistono — e nell’epoca dell’IA generativa, capace di correlare pattern su scala enorme, tendono a esistere sempre di più — il dato resta personale, e resta soggetto al Regolamento.
SI, questa operazione riguarda una società americana, lavoratori soggetti prevalentemente al diritto USA, e si tratta dunque di una procedura fallimentare che non ricade sotto la giurisdizione del GDPR. Ma il caso è comunque utile interessante per le aziende europee, per due ragioni. Primo, perché lo stesso schema — “i dati aziendali come asset liquidabile in una crisi d’impresa” — può replicarsi anche qui, dove il GDPR impone vincoli molto più stringenti su una eventuale cessione. Secondo, perché la stessa ambiguità tecnica tra deidentificazione e vera anonimizzazione è al centro di molte valutazioni che i DPO italiani sono chiamati a fare ogni giorno, ad esempio quando un cliente propone di condividere “dati anonimi” per finalità di analytics o di addestramento di modelli.
Un cambio di paradigma nella gestione delle crisi d’impresa
Al di là del singolo caso, l’operazione Google-Spirit segna probabilmente uno spartiacque nel modo in cui curatori fallimentari, advisor M&A e liquidatori guarderanno agli asset aziendali. Fino a ieri, in una procedura concorsuale, il “tesoro” da liquidare erano gli asset fisici e finanziari: immobili, macchinari, crediti, marchi. Da oggi, accanto a questi, entra a pieno titolo un nuovo asset: il patrimonio informativo dell’azienda, ossia l’insieme delle tracce digitali prodotte in anni di attività — comunicazioni interne, know-how procedurale, storico decisionale.
Per le aziende italiane ed europee questo apre alcune riflessioni molto concrete, che vanno ben oltre lo scenario del fallimento:
- Data governance e contrattualistica: nei contratti con fornitori cloud, software gestionali, piattaforme di collaborazione, andrebbe sempre disciplinato cosa succede ai dati aziendali (compresi quelli dei dipendenti) in caso di cessazione dell’attività, cessione di ramo d’azienda, fusione o acquisizione. È un tema di due diligence che oggi viene spesso trattato solo dal punto di vista IP e finanziario, trascurando l’impatto privacy.
- Minimizzazione e retention: più dati un’azienda accumula senza una politica di conservazione e cancellazione, più cresce il “valore” — e quindi anche il rischio, in caso di crisi o di data breach — del proprio patrimonio informativo interno. Il principio di minimizzazione dell’art. 5 GDPR non è solo un adempimento formale: è anche una forma di riduzione del rischio patrimoniale.
- AI Act e dati di addestramento: il Regolamento europeo sull’IA impone obblighi di trasparenza e governance sui dati utilizzati per addestrare sistemi di IA, in particolare per i modelli a uso generale. Un’azienda europea che si trovasse, in futuro, a valutare l’acquisizione o l’utilizzo di dataset “opachi” come quello Spirit dovrebbe interrogarsi non solo sulla liceità GDPR della fonte, ma anche sulla tracciabilità richiesta dall’AI Act lungo tutta la filiera dei dati di addestramento.
- Rappresentanza dei lavoratori: la vicenda mostra che le comunicazioni interne dei dipendenti — email, chat, documenti di lavoro — sono oggi un dato ad altissimo valore commerciale, non un semplice sottoprodotto dell’attività lavorativa. Le organizzazioni sindacali e i rappresentanti dei lavoratori per la protezione dei dati avranno probabilmente sempre più voce in capitolo su come questi archivi vengono trattati, anche in scenari non emergenziali.
Una riflessione finale
C’è qualcosa di rivelatore nel fatto che, per addestrare un’intelligenza artificiale a comportarsi come un impiegato, occorra comprare gli errori, le esitazioni e le incomprensioni di migliaia di impiegati veri. È la conferma che il lavoro d’ufficio — quello fatto di sfumature, di relazioni, di giudizio nel contesto — resta, almeno per ora, più difficile da replicare di quanto si tenda a credere.
Ma è anche un promemoria per chi si occupa di compliance: nell’economia dei dati, ogni email scritta oggi da un dipendente potrebbe, un giorno, diventare un asset ceduto a un terzo che nessuno ha mai autorizzato esplicitamente. Non è uno scenario da fantascienza normativa: è già successo, in tribunale, nell’agosto 2026. La domanda che ogni organizzazione dovrebbe porsi non è se questo possa accadere anche a lei, ma se, il giorno in cui dovesse accadere, i propri contratti, le proprie policy e la propria governance dei dati sarebbero pronti a rispondere.
FinData supporta imprese manifatturiere, software house e organizzazioni tecnologiche nell’analisi del perimetro AI e nella definizione di percorsi formativi adeguati volti a rendere consapevole e conforme l’utilizzo di intelligenze artificiali in azienda.
Fonti: Axios, Bloomberg Law, Fortune, Cybernews, TechStartups, AfterDawn — articoli pubblicati tra il 17 e il 25 agosto 2026 sulla base degli atti depositati presso lo United States Bankruptcy Court for the Southern District of New York.